Construyendo un segundo cerebro con el que puedo hablar
Todos necesitamos asistir a nuestra limitada memoria con un bloc de notas. Primero fue boli y papel, un post-it por temática hasta llenar la nevera. Después llegaron las apps de notas, con anidamiento, etiquetas, búsqueda y sincronización en la nube, y apuntar cualquier cosa desde el móvil pasó a costar dos segundos.
Pero hay un problema que sigue estando ahí: la mantenibilidad y escalabilidad de nuestras notas. Cuando acumulamos muchos bloques de información, nos volvemos más lentos a la hora de encontrarlos. Llega un punto en el que tenemos tantas notas que nos olvidamos de que alguna existe, y mantener el mapa mental de dónde está cada cosa cuesta más que la propia nota.
Muchas personas también tenemos, o hemos tenido en algún momento, una conversación con nosotros mismos donde vamos tirando notas sin orden, donde solo pesan las últimas, y las que quedan atrás pasan directamente a un limbo.
El objetivo final ideal es que ese limbo se clasifique y se ordene solo: dejar de organizar la vida alrededor de aplicaciones, y convertir años de opiniones apuntadas en un modelo personal de preferencias al que se le puede preguntar.
Lo que he montado para intentarlo son cuatro piezas: Obsidian como memoria, Hermes Agent como arnés que lo orquesta, un modelo de lenguaje como inteligencia y Telegram como única puerta de entrada. Con Whisper transcribiendo por el camino, porque casi todo lo que le mando son notas de voz.
La memoria que traen los asistentes vive en el servidor de quien te la presta y solo la usa esa aplicación. Aquí son ficheros Markdown en mi disco: los abro y los edito con Obsidian, y cualquier otra herramienta puede leerlos.
Obsidian, la memoria
La primera es Obsidian, una aplicación de notas y gestión de conocimiento personal conceptualmente simple, pero tremendamente potente y extensible.
Obsidian funciona especialmente bien porque, por defecto, tus notas se almacenan localmente. No dependen de servidores de terceros y eres tú quien tiene el control sobre tus datos. Esto implica asumir algo más de trabajo si quieres sincronizarlas entre varios dispositivos, algo que la propia compañía resuelve con Obsidian Sync, pero en mi opinión el beneficio compensa con creces el coste.
Hermes Agent, el arnés
La siguiente pieza es Hermes Agent, de Nous Research. Y aquí es donde el sistema empieza realmente a cobrar vida.
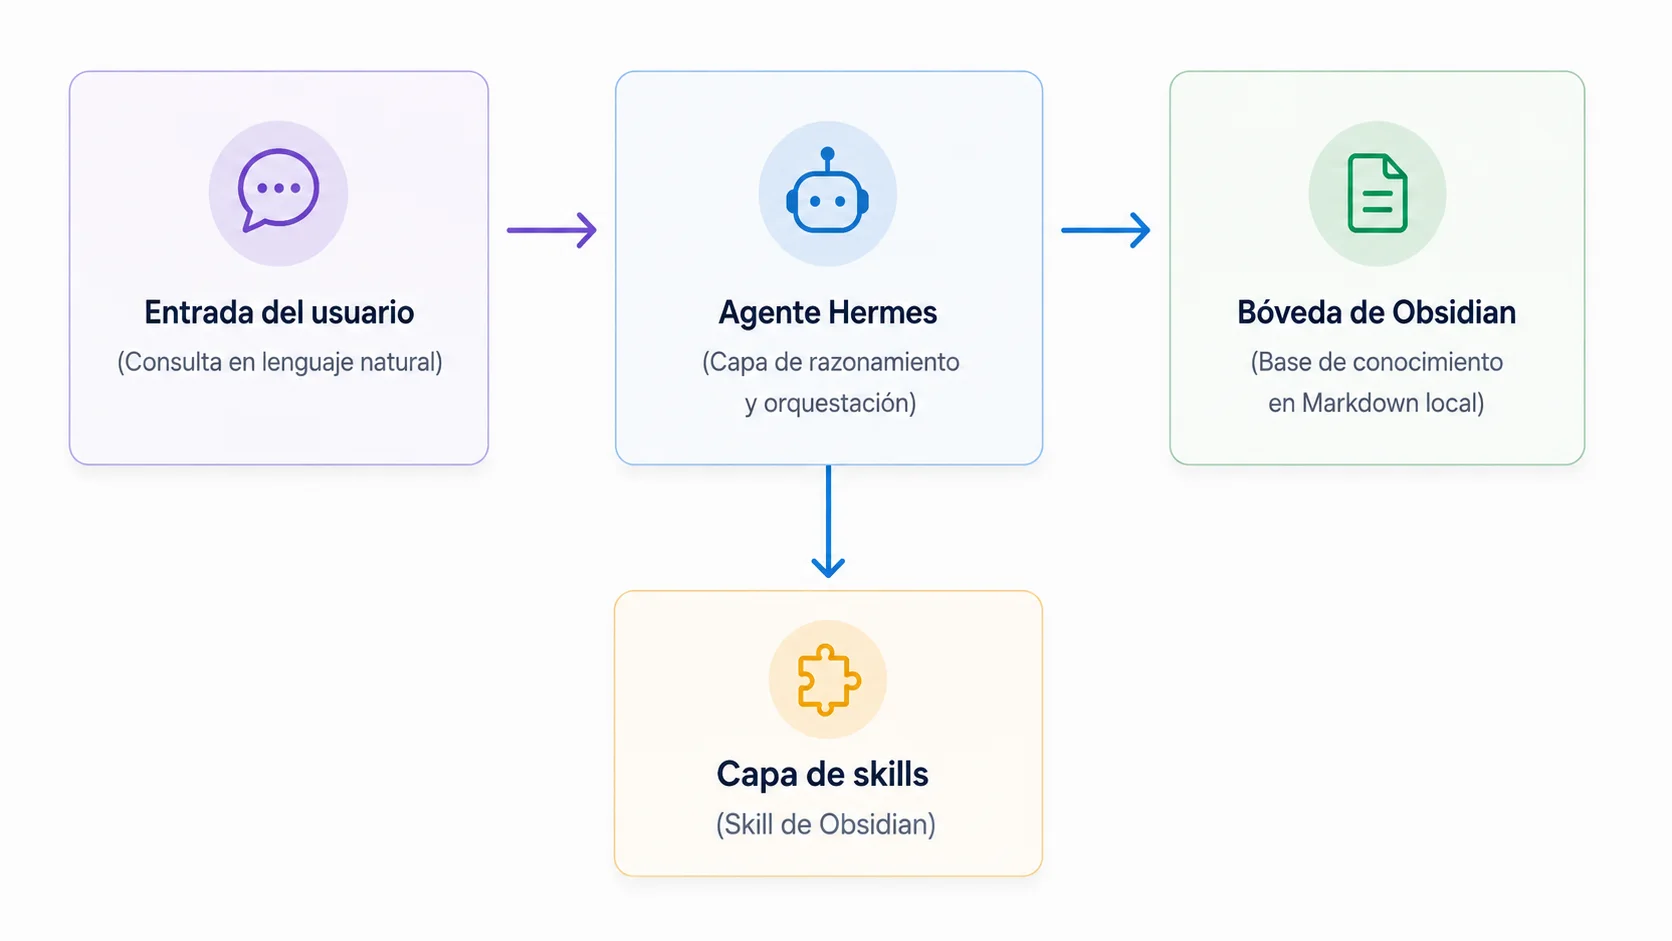
Hermes Agent es un agent harness: una capa de software que podemos mantener ejecutándose permanentemente en una máquina, una VM, un servidor doméstico o incluso un Mac encendido 24/7, y que se encarga de conectar todas las piezas del sistema.
Podemos configurarle diferentes canales para interactuar con él. En mi caso, utilizo Telegram. Mi asistente se llama Botiño y está literalmente a un mensaje de distancia desde el móvil. Puedo escribirle, enviarle una nota de voz o pedirle que haga algo, y Hermes se encarga de recibir esa intención, mantener el contexto, decidir qué necesita para resolverla y ejecutar las acciones correspondientes.
Importante: limitar el bot a tu propio user ID, que te lo da @userinfobot. Si no, cualquiera que dé con el bot puede escribir en tu vault.
Es, en esencia, la capa de enrutado entre nosotros, nuestra memoria y las herramientas que tenemos disponibles.
El modelo, la inteligencia
Hermes necesita, eso sí, un modelo de lenguaje que aporte la capacidad de razonamiento necesaria para interpretar nuestras peticiones, utilizar herramientas y decidir qué acciones ejecutar.
Con hardware suficiente, lo ideal es un modelo local capaz de trabajar de forma agéntica, como Qwen3.8-27B: se usa el asistente de forma intensiva sin pagar por petición y, sobre todo, el procesamiento de las notas no sale de casa.
Para quien quiera reducir la barrera de entrada, Codex es una alternativa asequible: se puede aprovechar una suscripción de gama baja de ChatGPT y utilizarla como motor del agente. El peaje conviene decirlo en voz alta, porque por ahí se va parte del argumento de la privacidad: el vault sigue siendo tuyo y sigue en tu disco, pero los fragmentos que el agente necesita leer para responderte salen de tu máquina.
Lo importante es que el modelo no es una pieza fija de la arquitectura. Hoy puede ser uno, mañana otro en nuestra propia máquina, y más adelante cualquiera que sea suficientemente capaz de trabajar de forma agéntica.
La memoria, en todas partes
Hay una última pieza necesaria para que todo esto resulte realmente cómodo: poder acceder a la misma memoria desde cualquier dispositivo.
Como Obsidian almacena el vault como ficheros Markdown normales, utilizo Syncthing para mantener una copia completa en tres sitios: mi Mac, mi Pixel y Cies, la máquina donde corre Hermes.
No existe una copia central ni una nube que actúe como intermediaria. Los tres dispositivos mantienen su propio vault y sincronizan los cambios directamente entre ellos a través de mi red privada de Tailscale.
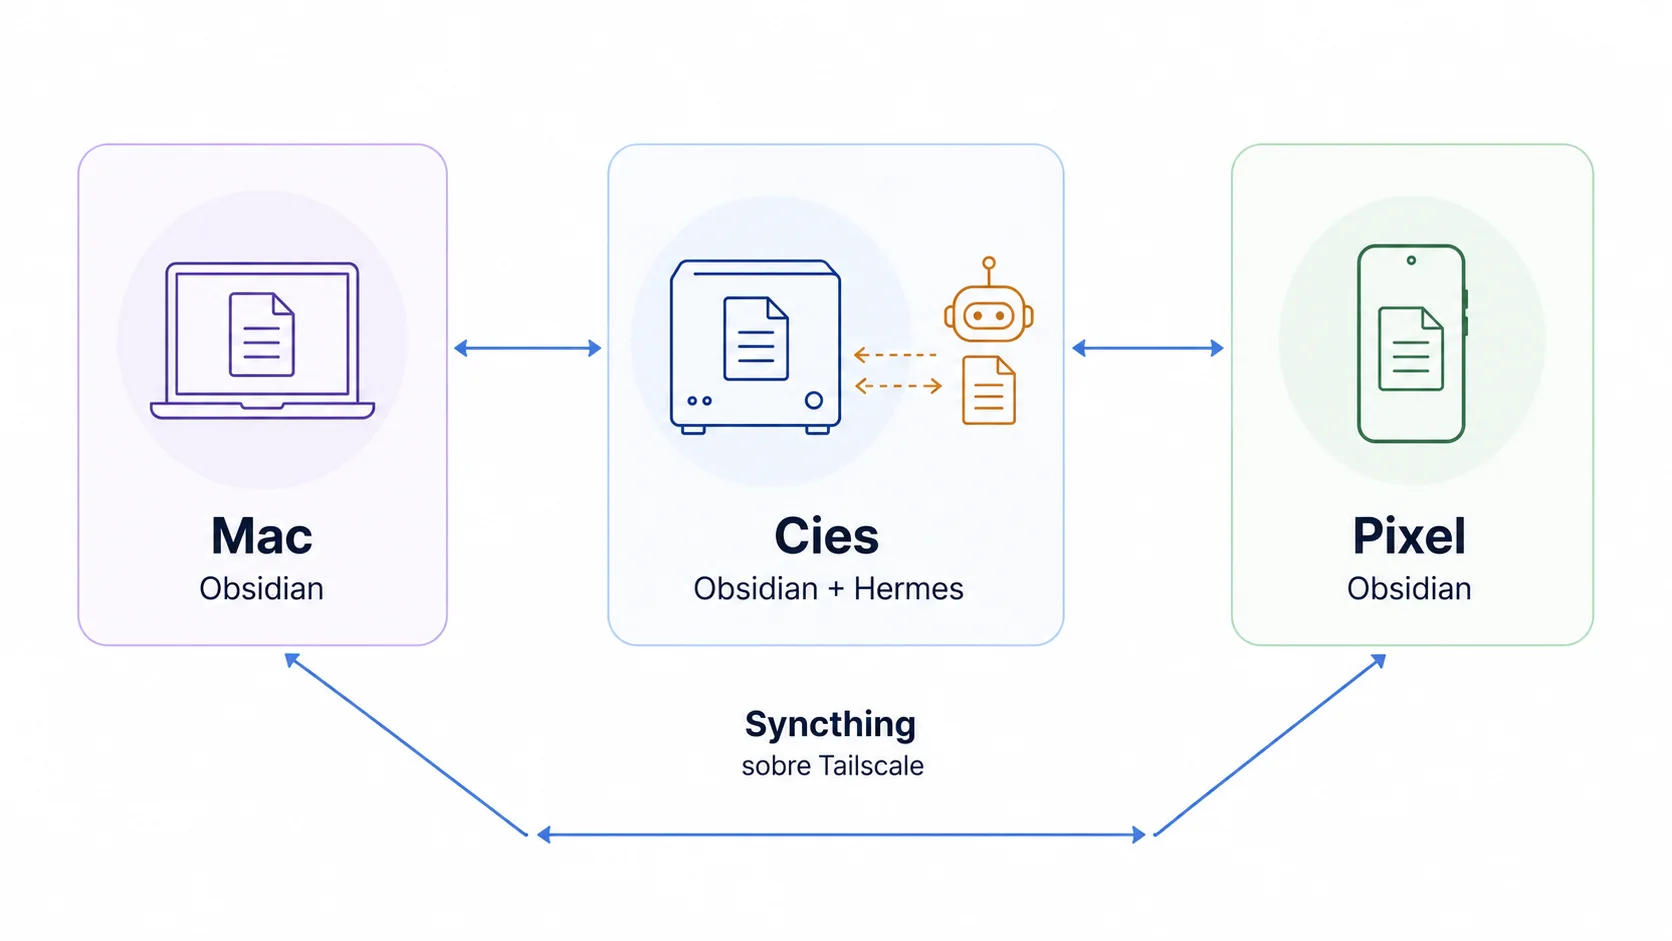
Hermes, de hecho, ni siquiera necesita saber que Syncthing existe. Lee y escribe directamente sobre los Markdown de Cies. Si le pido desde Telegram que guarde una idea, modifica el vault local y unos segundos después esa nota aparece en mi Mac y en el móvil. Y si escribo algo desde Obsidian en el Pixel, poco después Hermes puede encontrarlo desde Cies.
El resultado es sencillo: no hay ningún servicio de notas que sea el dueño de mi memoria. Son ficheros míos, en todos mis dispositivos, sincronizados directamente entre ellos.
Una sola puerta de entrada
Y esta capa de enrutado cambia por completo nuestra relación con las aplicaciones.
Ya no necesito una aplicación específica para registrar mis entrenamientos, otra para guardar recetas, otra para llevar una lista de libros que quiero leer y otra para gestionar mis ideas. Puedo simplemente decírselo a Hermes.
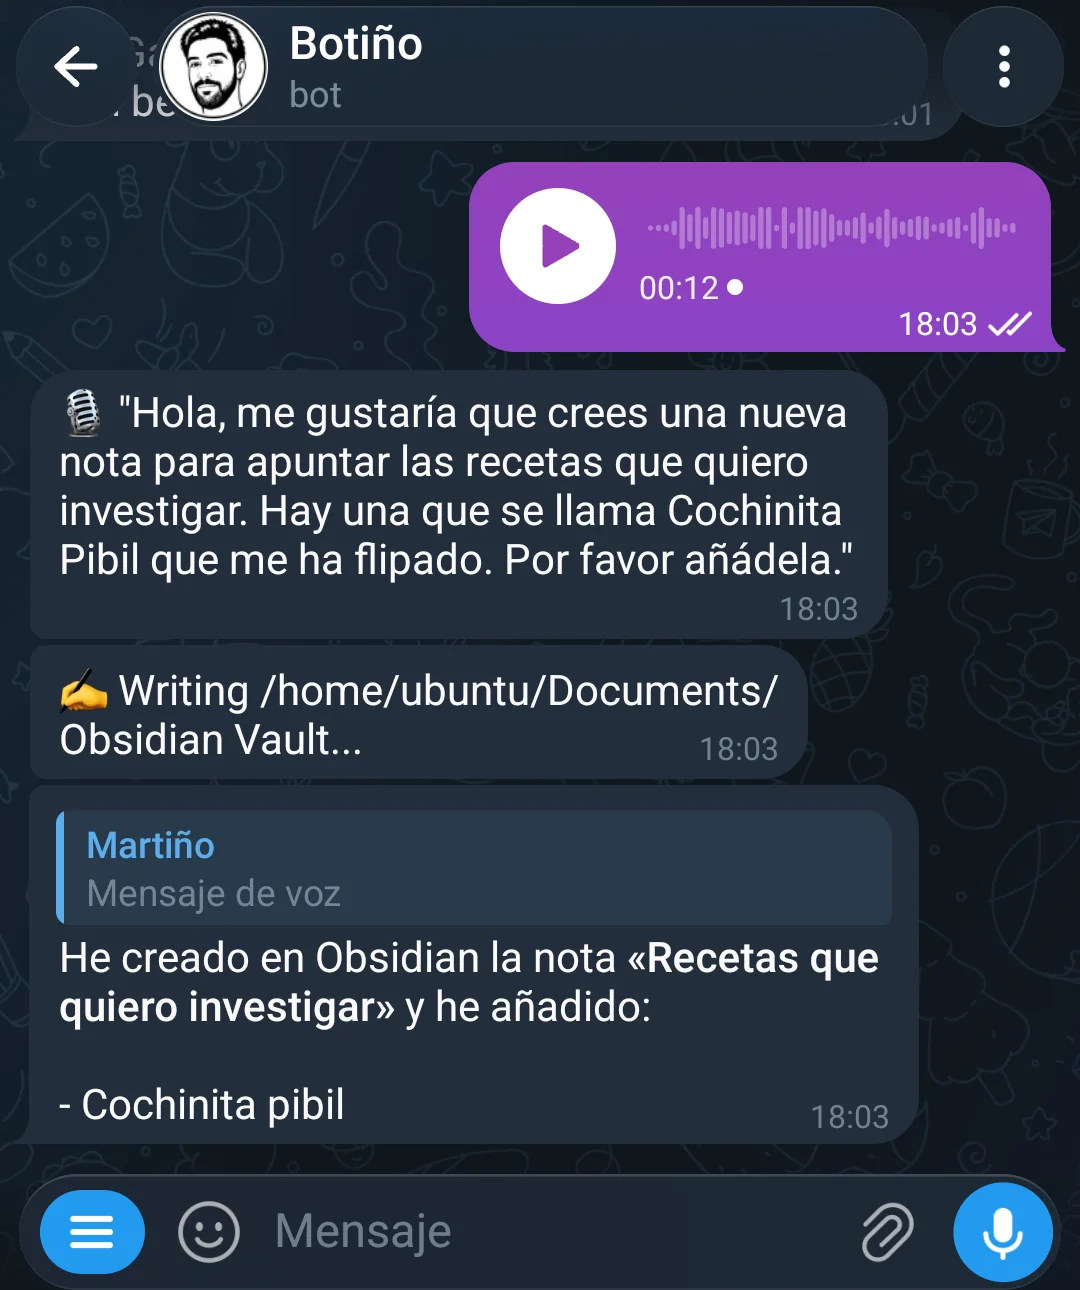
Estoy en el gimnasio y le envío una nota de voz por Telegram, que inmediatamente recibe y transcribe con un modelo Whisper local:
“Hoy press banca, 90 kilos, tres series de ocho. Luego press inclinado, 35 kilos por mancuerna, tres series de diez. El hombro derecho me ha molestado un poco en la última serie.”
Hermes recibe el audio, lo procesa y puede utilizar el modelo y las herramientas disponibles para entender qué información contiene, estructurarla y almacenarla en Obsidian.
Yo no tengo que decidir si esto va a Gym, Recetas, Finanzas, Salud o a una aplicación especializada.
Ese trabajo lo hace la capa de enrutado.
Cómo decide dónde va cada cosa
Lo interesante es lo poco que hay escrito. Mis instrucciones permanentes ocupan menos de mil bytes y, sobre el vault, solo fijan tres cosas: la ruta absoluta, que las notas nuevas van a Notas/ y las capturas rápidas a Inbox/, y que no ponga un título como primera línea, porque Obsidian ya usa el nombre del fichero. No hay ni una sola regla que diga que el press banca va a Gym.
Encima de eso está la capa de skills: instrucciones que el agente carga solo cuando le hacen falta. La de Obsidian le enseña a leer, buscar, crear y añadir sobre ficheros Markdown, y le insiste en resolver la ruta del vault antes de tocar nada.
Con eso, la decisión la toma el modelo mirando lo que ya hay. Busca antes de escribir. Si encuentra una nota de recetas, añade. Si no encuentra nada parecido, la crea. Mis dos carpetas no son un esquema de clasificación: son un sitio donde vive la memoria y otro donde cae lo que todavía no se ha ordenado.
Habrá que ver hasta dónde aguanta. Ahora mismo el vault es pequeño y el modelo se lo lee entero sin despeinarse. La pregunta es qué pasa cuando crezca, tanto en número de notas como en temas distintos: si llegará un punto en el que haga falta más tecnología por debajo, índices, estructura, búsqueda de verdad, o si la propia mejora de los modelos se lo va a ir comiendo sin que yo tenga que tocar nada.
Y aquí aparece una consecuencia que me parece mucho más importante que simplemente tener un asistente capaz de ejecutar comandos: ya no tenemos que organizar nuestra vida alrededor de aplicaciones.
Podemos tener una única puerta de entrada y dejar que el agente decida dónde debe terminar cada cosa.
Y la puerta funciona en los dos sentidos. Si añadimos un sistema de generación de voz como VibeVoice, podemos preguntarle desde Telegram por información almacenada en nuestro segundo cerebro y recibir la respuesta directamente como audio.
Por ejemplo:
“Busca en toda mi documentación sobre arquitectura de software qué decisiones tomamos sobre event-driven architecture, qué problemas tuvimos con ellas y qué cambiaríamos hoy.”
Hermes puede localizar la documentación relevante, utilizar el modelo para analizarla, sintetizar las conclusiones y devolvernos un audio explicando la respuesta.
Limitaciones
Hermes trae Whisper en local, pero por defecto usa el modelo base, y en español no hay quien lo entienda: se come palabras y destroza cualquier nombre propio. Pasarlo a small lo arregló.
Un modelo personal de preferencias
Imaginemos que durante años hemos ido guardando películas que hemos visto, nuestra valoración, notas sobre ellas y, sobre todo, por qué nos han gustado o no.
Si alguien nos recomienda una película nueva, podemos preguntarle:
“Me han recomendado X. ¿Crees que me va a gustar?”
Hermes puede localizar nuestras notas relevantes y utilizar el modelo para analizarlas junto con la información disponible sobre la película. En lugar de limitarse a buscar películas similares, puede razonar sobre nuestras propias preferencias:
“Creo que tienes bastantes probabilidades de que te guste. En tus notas valoras especialmente la fotografía, la construcción de mundos y las historias de ciencia ficción con cierta carga filosófica. Sin embargo, has penalizado varias veces las películas con un ritmo demasiado lento, así que ese podría ser el principal riesgo.”
Estamos convirtiendo nuestro historial de decisiones y opiniones en un modelo personal de preferencias.
Y cuanto más utilizamos el sistema, más contexto tiene para razonar sobre nosotros. No porque exista necesariamente una base de datos perfectamente estructurada de “cosas que me gustan”, sino porque existe un conjunto de recuerdos, experiencias, decisiones y explicaciones sobre los que el agente puede trabajar.
La inteligencia del sistema crece no solo porque mejoren los modelos, sino porque aumenta la cantidad y calidad de contexto personal sobre el que pueden razonar.